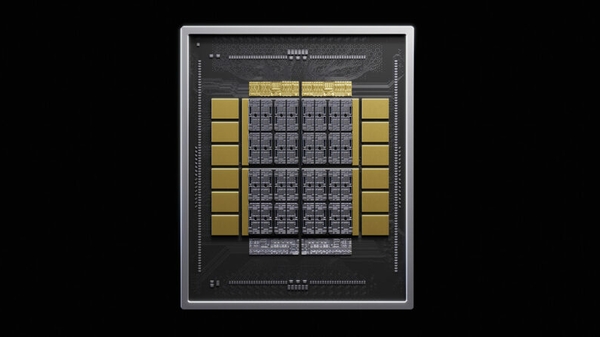
NVIDIA NVLink Fusion通过NVHBM定制高带宽内存扩展
随着AI代理和万亿参数工作负载的普及,AI基础设施的性能不仅取决于计算能力,还取决于计算、内存、存储、网络和软件作为统一系统的设计。NVIDIA通过NVHBM定制高带宽内存扩展其NVLink Fusion,助力超大规模数据中心和AI创新者构建下一代AI基础设施。
这条 模型/产品 信号说明,来自 NVIDIA Newsroom 的信息已经不只是单点新闻,而是值得放进产品、研究和行业判断里的趋势线索。

随着AI代理和万亿参数工作负载的普及,AI基础设施的性能不仅取决于计算能力,还取决于计算、内存、存储、网络和软件作为统一系统的设计。NVIDIA通过NVHBM定制高带宽内存扩展其NVLink Fusion,助力超大规模数据中心和AI创新者构建下一代AI基础设施。
这条 模型/产品 信号说明,来自 NVIDIA Newsroom 的信息已经不只是单点新闻,而是值得放进产品、研究和行业判断里的趋势线索。
NVIDIA Newsroom 发布了这条关于 模型/产品 的更新:随着AI代理和万亿参数工作负载的普及,AI基础设施的性能不仅取决于计算能力,还取决于计算、内存、存储、网络和软件作为统一系统的设计。NVIDIA通过NVHBM定制高带宽内存扩展其NVLink Fusion,助力超大规模数据中心和AI创新者构建下一代AI基础设施。
这是一个具体的AI基础设施产品升级,体现了AI硬件设计的最新发展,推动大型AI模型和系统性能提升,符合模型产品类别。
产品团队、创业者和平台生态观察者 应该重点关注这条信号,尤其是正在跟踪 models、products 的团队。
接下来观察这条信号是否出现开发者采用、竞品回应、研究复现、企业部署或政策/平台层面的后续动作。

随着 AI 模型规模和推理复杂度的增加,AI 工厂需要更强大的计算能力。NVIDIA 推出的 NVLink Fusion 技术结合了 NVHBM,高效支持大规模 AI 计算需求。

阿里巴巴发布了Qwen3.8-Flash-Next模型权重,作为即将发布的Qwen4架构的预览,供开发者进行实验和评估。

阿里巴巴发布了Qwen3.8-Flash-Next模型权重,作为即将推出的Qwen4架构的预览,供开发者实验和评估。该模型在NVIDIA硬件上展现了自主编码能力。